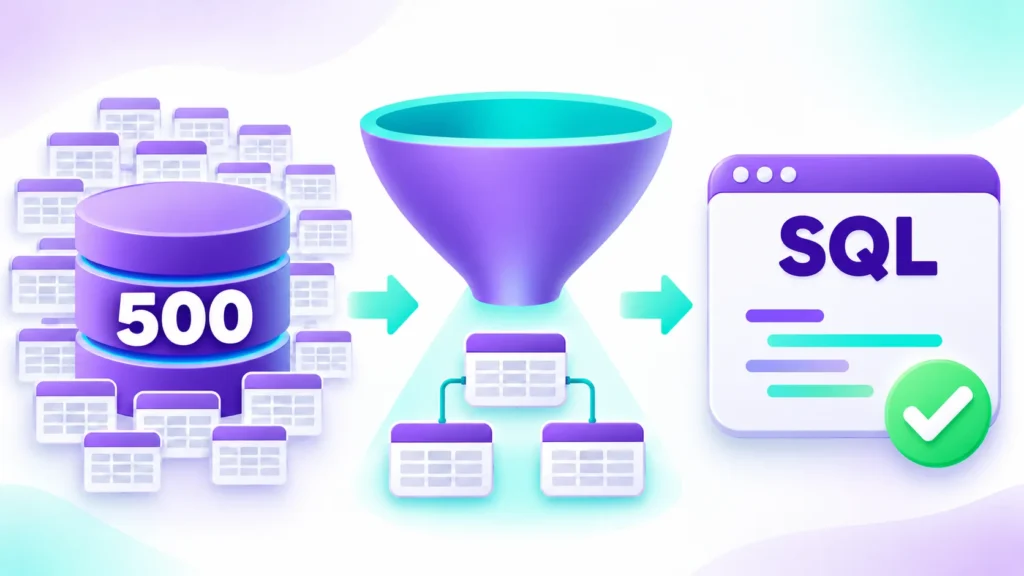
Su un database piccolo, con nomi chiari e poche relazioni, un modello di AI può trasformare una domanda in una query SQL plausibile. Quando però lo schema contiene centinaia di tabelle, viste storiche, sigle interne e percorsi di join diversi, scrivere SQL è soltanto l’ultimo tratto del percorso.
Prima bisogna capire quali parti del database servono, che cosa significano per l’azienda e come possono essere collegate senza alterare il risultato. Dopo, occorre verificare che la query sia non solo eseguibile, ma anche coerente con la domanda e con le regole di accesso.
È questa la differenza tra una demo che genera codice e un sistema text-to-SQL che può essere valutato per un uso reale.
In breve: su database complessi non basta chiedere a un modello di generare SQL. Servono almeno selezione del contesto, schema linking, conoscenza delle relazioni, definizioni di business, validazione ed esecuzione controllata.
Perché 500 tabelle cambiano il problema
“500 tabelle” non è una soglia tecnica universale. È un modo concreto per rappresentare ciò che accade quando lo schema non può più essere trattato come un elenco da incollare in un prompt.
In un database aziendale possono convivere:
- tabelle operative e copie storiche;
- viste create per report specifici;
- sigle comprensibili solo a chi conosce il gestionale;
- colonne con nomi simili ma significati diversi;
- relazioni dichiarate nel database e join usati soltanto nel codice applicativo;
- anagrafiche duplicate o specializzate per area;
- regole di business che non compaiono nello schema;
- personalizzazioni diverse per cliente o versione del software.
Se tutto questo contesto viene fornito indiscriminatamente al modello, aumenta il rumore e diventa più difficile individuare gli oggetti corretti. Se invece il contesto viene ridotto troppo, può mancare proprio la tabella, la relazione o la regola necessaria alla risposta.
Il problema centrale diventa quindi recuperare il contesto giusto per quella domanda, non mostrare al modello tutto ciò che esiste.
Cinque modi in cui l’AI può produrre SQL valido e una risposta sbagliata
1. Seleziona la tabella plausibile, non quella autorevole
Immaginiamo che un gestionale contenga ORD_T, FAT_T, MOV_MAG, V_RICAVI e una vista storica chiamata RICAVI_OLD. Alla domanda “Quali clienti hanno generato più ricavi?”, più oggetti possono sembrare pertinenti.
La scelta corretta dipende dal significato aziendale di “ricavi”, dal periodo, dallo stato dei documenti e dalla fonte considerata ufficiale. Il nome più intuitivo non è necessariamente la fonte canonica.
Questo è un problema di schema linking: collegare i concetti della domanda agli oggetti corretti del database prima di generare la query.
2. Interpreta una sigla senza conoscerne il significato locale
Nei database reali, nomi come CD_CL, TIP_DOC, FL_AN, DT_EV o QTA_UM2 non spiegano da soli che cosa rappresentano. Un modello può formulare un’ipotesi ragionevole, ma un’ipotesi non è una definizione.
Anche i valori possono essere opachi. Un campo STATO = 'C' potrebbe significare chiuso, confermato, contabilizzato o cancellato. La sintassi SQL non risolve l’ambiguità.
Servono descrizioni, esempi controllati, documentazione e conoscenza del dominio. Se il significato resta incerto, il comportamento più affidabile non è indovinare: è chiedere un chiarimento o segnalare il limite.
3. Sceglie un join possibile ma non corretto
Due tabelle possono essere collegate in più modi. Una query può superare il controllo sintattico, essere eseguita e restituire righe senza che il percorso di join sia quello appropriato.
Il rischio aumenta con relazioni uno-a-molti e molti-a-molti. Collegare testate, righe, movimenti e anagrafiche senza considerare la granularità può duplicare importi e gonfiare un totale. In altri casi, un filtro applicato dopo il join elimina record che avrebbero dovuto restare nell’analisi.
Per evitare questi errori, il sistema deve conoscere non soltanto le chiavi, ma anche:
- cardinalità delle relazioni;
- percorsi di join ammessi;
- granularità di ogni tabella;
- viste o modelli preferiti;
- eccezioni che possono generare duplicazioni.
4. Traduce bene la frase, ma non la regola aziendale
Termini come fatturato, ordine acquisito, cliente attivo, margine o prodotto venduto non hanno sempre una definizione unica.
Lo schema dice dove si trovano importi, date e stati. Non dice necessariamente quale combinazione usa il controllo di gestione, quali documenti vanno esclusi o come trattare resi e note di credito.
Questo livello di significato può essere reso disponibile attraverso descrizioni, glossari, query verificate, regole e un semantic layer. Il punto non è aggiungere testo generico al prompt, ma collegare le definizioni ai dati e mantenerle aggiornate.
5. Verifica che la query funzioni, non che la risposta sia corretta
Una query eseguibile non è automaticamente una query corretta. Può usare tabelle e colonne esistenti, restituire un risultato plausibile e rispondere a una domanda diversa da quella formulata dall’utente.
Per questo i sistemi text-to-SQL vanno valutati sul risultato e sul ragionamento operativo che lo ha prodotto. La ricerca sul tema e benchmark come BIRD e LiveSQLBench mettono l’accento sull’esecuzione e sulla corrispondenza dei risultati, non soltanto sulla somiglianza tra stringhe SQL.
In produzione, la verifica dovrebbe includere domande reali, risultati attesi, casi ambigui e test di regressione. La domanda utile non è “ha generato una query?”, ma “ha usato le fonti, le relazioni e le regole che avremmo approvato?”.
Che cosa serve oltre al prompt
Un sistema affidabile per database complessi non coincide con un singolo modello. È una pipeline in cui ogni passaggio riduce una classe diversa di errore.
1. Onboarding e catalogazione dello schema
Il primo passaggio è esplorare il database e costruire una rappresentazione utilizzabile di tabelle, colonne, tipi, chiavi e relazioni. Dove possibile, questa base va arricchita con descrizioni, sinonimi, valori esemplificativi controllati e indicazioni sulle fonti canoniche.
L’onboarding non è un’attività da dimenticare dopo la prima configurazione. Se cambiano lo schema, le viste o le personalizzazioni del gestionale, il contesto deve essere aggiornato e versionato.
2. Recupero selettivo del contesto
Alla domanda dell’utente, il sistema deve restringere lo spazio di ricerca: individuare le tabelle candidate, recuperare le relazioni pertinenti e includere soltanto le informazioni utili alla query.
Questo passaggio riduce il rumore e rende più gestibile uno schema grande. Deve però poter ampliare la ricerca quando il primo insieme di tabelle non basta, invece di forzare una risposta con un contesto incompleto.
3. Schema linking e pianificazione dei join
Prima di scrivere SQL, occorre collegare metriche, entità, filtri e periodi della domanda agli oggetti reali del database. Nei casi complessi è utile pianificare il percorso di join e controllare la granularità delle fonti.
Se esistono più percorsi plausibili, il sistema dovrebbe confrontarli, usare regole note o chiedere conferma. Nascondere l’ambiguità dietro una query ben formattata rende il risultato più rischioso, non più affidabile.
4. Contesto semantico e regole di business
Le definizioni aziendali devono essere disponibili nel momento in cui la domanda viene interpretata. Possono includere:
- formule approvate per KPI e metriche;
- sinonimi usati dagli utenti;
- stati e codici da includere o escludere;
- gerarchie geografiche o organizzative;
- filtri obbligatori;
- query di riferimento già validate.
Questo contesto non sostituisce lo schema: lo rende leggibile secondo il modo in cui l’organizzazione usa i dati.
5. Generazione, validazione ed esecuzione controllata
Solo a questo punto viene generata la query. Prima dell’esecuzione, possono essere applicati controlli su:
- sintassi e dialetto SQL;
- esistenza di tabelle e colonne;
- operazioni consentite;
- identità e permessi dell’utente;
- limiti di righe, tempo e risorse;
- presenza di filtri obbligatori;
- coerenza con join e metriche approvati.
L’esecuzione può inoltre fornire segnali utili: errori, risultati vuoti o distribuzioni anomale possono attivare una correzione, una richiesta di chiarimento o una revisione umana. Non tutto deve essere risolto automaticamente.
6. Osservabilità, feedback e test di regressione
Un sistema che funziona oggi può cambiare comportamento dopo l’aggiornamento di uno schema, di una regola o del modello. Servono log, versionamento del contesto, raccolta delle correzioni e una serie di domande di riferimento da rieseguire nel tempo.
Il feedback più utile non è un generico pollice in su. È sapere quale tabella, join, filtro o definizione ha prodotto l’errore e trasformare la correzione in conoscenza riutilizzabile.
Un esempio: “ricavi netti per cliente negli ultimi 12 mesi”
Consideriamo un esempio illustrativo, non un test DataTalk né un caso cliente.
Un database gestionale contiene testate e righe di ordini, fatture e note di credito, oltre ad anagrafiche clienti, cambi valuta, movimenti di magazzino e viste storiche. L’utente chiede:
“Mostrami i ricavi netti per cliente negli ultimi 12 mesi, confrontati con i 12 mesi precedenti.”
Un generatore SQL deve prendere decisioni che la frase non esplicita:
- usare ordini, documenti emessi o merce spedita?
- quali stati rendono un documento valido?
- le note di credito vanno sottratte per data di emissione o collegate alla fattura originaria?
- gli importi sono già al netto di sconti e imposte?
- come si trattano valute diverse?
- “cliente” indica l’intestatario, il gruppo o la destinazione commerciale?
- il confronto usa mesi mobili o anni solari?
La query finale può essere lunga, ma la difficoltà principale non è la lunghezza. È scegliere correttamente le definizioni e le fonti prima di scriverla.
Un flusso credibile dovrebbe quindi:
- riconoscere metrica, entità e intervalli temporali;
- recuperare le fonti candidate e le regole sui ricavi netti;
- verificare relazioni e granularità;
- chiedere chiarimenti sulle ambiguità non risolte;
- generare la query;
- validarla ed eseguirla con permessi limitati;
- presentare risultato, filtri e provenienza in modo verificabile.
Come testare un sistema text-to-SQL su un database reale
Una demo su tre tabelle ben nominate misura soprattutto la capacità del modello di scrivere SQL. Per valutare l’idoneità a un database aziendale serve un pilot più rappresentativo.
Checklist per il pilot
- Scegliere un database con complessità simile a quella di produzione.
- Definire 20-30 domande reali, non costruite soltanto per la demo.
- Includere richieste semplici, multi-tabella, ambigue e non risolvibili senza chiarimento.
- Preparare risultati o query di riferimento approvati dal data team.
- Verificare correttezza delle fonti, dei join, dei filtri e delle metriche.
- Testare due ruoli con perimetri di accesso differenti.
- Inserire casi con tabelle legacy, nomi simili e valori codificati.
- Misurare quante correzioni richiedono modifiche al contesto, non soltanto al prompt.
- Ripetere i test dopo un cambiamento di schema o configurazione.
- Stabilire quando il sistema deve rispondere, chiedere chiarimenti o astenersi.
Questo approccio permette di confrontare sviluppo interno e integrazione su criteri osservabili. Se stai valutando le due strade, puoi approfondire anche che cosa comporta integrare l’AI in un gestionale rispetto a costruirla internamente.
Dove si colloca DataTalk API
DataTalk API è pensata per software house, SaaS, system integrator e team tecnici che vogliono aggiungere interrogazioni in linguaggio naturale a prodotti, tool interni e workflow AI.
L’approccio non si limita alla generazione di SQL. Durante l’onboarding, DataTalk esplora la struttura del database e costruisce un contesto utilizzabile dall’agente. Quando arriva una domanda, il sistema ricerca le informazioni rilevanti invece di trattare l’intero schema come un blocco unico.
La qualità va comunque verificata sul caso reale. Definizioni specifiche, permessi, criteri di validazione e modalità di esecuzione devono essere concordati e testati sul database e sul workflow del cliente.
Il punto di partenza migliore non è una domanda generica. È una richiesta che oggi richiede tempo a un analista, insieme alle query o ai risultati considerati corretti.
Vuoi verificare come si comporta l’AI su un database con tabelle, sigle e relazioni reali? Scopri DataTalk API e prepara un set di domande rappresentative per il pilot.